
Annotation & traitement de documents pour l'IA
Améliorez vos modèles d’analyse de documents grâce à un traitement rigoureux et une annotation de documents sur mesure. Nous vous aidons à structurer, extraire et enrichir vos documents bruts pour en faire une mine d'or pour l'IA



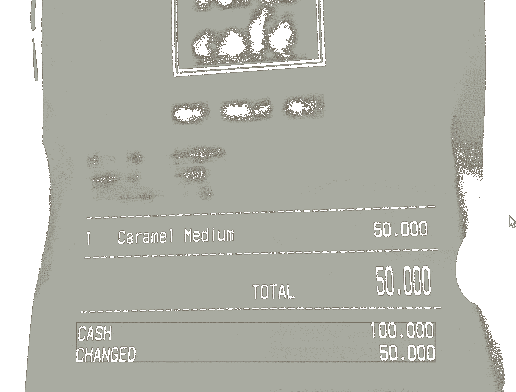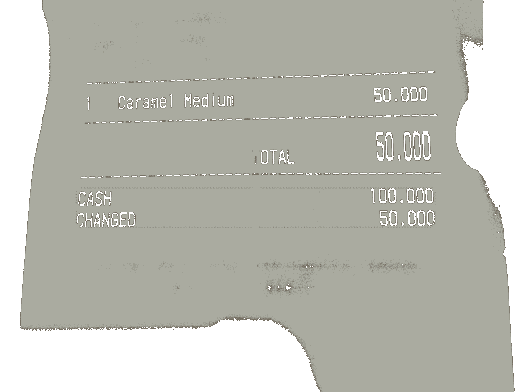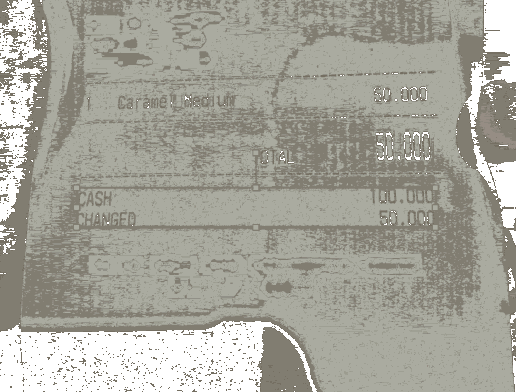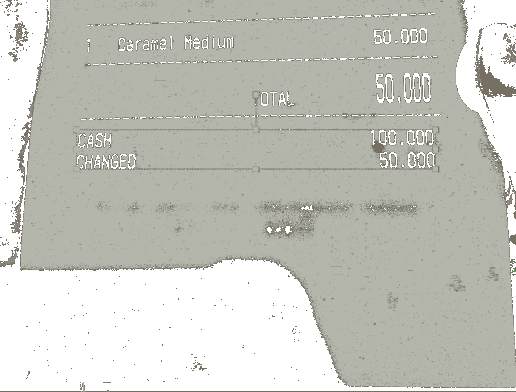
Nos experts transforment vos documents grâce à une maîtrise avancée de l’OCR et des outils d’annotation. Ce service de traitement intelligent de documents (IDP) combine OCR, annotation humaine et validation.
Extraction et structuration de documents
Traitement linguistique et multilingue
Classification de documents
Supervision et validation humaine
Extraction et structuration de documents
Nous extrayons et structurons les informations de vos documents, même manuscrits ou mal numérisés, pour en faire des données prêtes pour l'entraînement.

Annotation de documents
Repérer, marquer et qualifier les zones d’intérêt (entités, sections, champs…) dans des documents variés (PDF, contrats, formulaires, rapports) pour les rendre exploitables par des modèles d’IA. Cette annotation peut être sémantique, structurante ou sectorielle.
Identification des éléments clés à annoter y compris la reconnaissance d'entités nommées (NER) sur les dates, montants, organisations et parties.
Segmentation du document (zones, pages, blocs…)
Annotation manuelle via des outils adaptés
Export dans un format structuré (JSON, XML, COCO, etc.)
Factures – Identification et annotation des champs clés (TVA, total, fournisseur) pour l’automatisation comptable
Contrats – Marquage des clauses critiques (résiliation, engagement, obligations) dans des contrats complexes
Rapports médicaux – Annotation de segments cliniques (diagnostic, antécédents, traitements) pour structurer le document

Extraction de données clés
Identifier et extraire les informations essentielles contenues dans des documents variés (factures, contrats, formulaires, relevés…). Pour transformer des fichiers semi-structurés ou non structurés en données prêtes à l’usage, exploitables dans des outils métiers, bases de données ou pipelines IA.
Préparation du document (OCR si besoin, parsing selon le format : PDF, image, scan…)
Détection des blocs ou champs cibles (zones textuelles, tableaux, paragraphes, zones de formulaire)
Nettoyage et structuration des données extraites (normalisation, typage, enrichissement)
Export dans un format structuré compatible avec les systèmes (JSON, CSV, XML…)
Relevés bancaires – Extraction automatisée des montants, dates et bénéficiaires pour audit ou KYC
Dossiers clients – Récupération des données personnelles et références contractuelles pour intégration dans le CRM
Formulaires d’enquête – Extraction de réponses ou champs remplis pour l’analyse statistique ou la visualisation

Reconnaissance d'écriture manuscrite (HTR) et validation humaine
Détecter et transcrire les éléments écrits manuellement dans des documents scannés (formulaires papier, annotations sur PDF, courriers…), afin de les intégrer dans des bases de données ou des pipelines de traitement automatique. Elle repose sur des techniques combinant OCR spécialisé et validation humaine, en particulier dans les cas où l'écriture est difficilement lisible.
Détection manuelle des zones manuscrites dans les documents
Revue OCR et correction manuelle des transcriptions obtenues
Encodage dans des formats exploitables avec localisation si besoin (bounding box, page, ligne)
Export dans un format standardisé selon l’usage final (JSON, CSV, TXT…)
Courriers administratifs – Transcription des dates et annotations manuscrites, détection des signatures
Champs manuscrits de bordereaux – Extraction des remarques, quantités ou codes dans des documents logistiques
Formulaires médicaux papier – Transcription de commentaires manuscrits dans les dossiers patients

Structuration de documents complexes
Segmenter, hiérarchiser et baliser des documents longs, composites ou mal formatés (rapports annuels, contrats, dossiers réglementaires…), afin d’en faciliter l’accès, l’analyse ou le traitement automatique.
Segmentation logique du document en blocs de sens (résumés, clauses, graphiques, chapitres)
Balise ou étiquetage de chaque segment (type, fonction, lien hiérarchique)
Indexation ou structuration du contenu pour faciliter la recherche ou l’entraînement IA
Export dans un format hiérarchique adapté : JSON, XML, Markdown, etc.
Rapports réglementaires – Découpage automatique en chapitres, annexes et sections réglementaires
Études de marché PDF – Organisation logique des segments (résumé, données, graphiques, analyse)
Dossiers de due diligence – Segmentation de data rooms volumineuses pour revue ciblée

Normalisation des formats d'entrée
Transformer des documents hétérogènes (PDF natifs, scans, images, Word…) en fichiers standardisés, nettoyés et homogènes, afin de garantir leur compatibilité avec les outils de traitement automatique (OCR, extraction, classification, annotation…).
Analyse des variations de format dans le corpus (résolution, type de fichier, orientation, encodage…)
Nettoyage visuel ou structurel des documents (redressement, suppression des artefacts, uniformisation des marges)
Renommage et classement logique des fichiers selon un standard défini (par lot, par catégorie, par client, etc.)
Export dans un répertoire ou système conforme au pipeline métier ou IA
Documents clients internationaux – Standardisation de la mise en page et des champs attendus
Scans contractuels – Redressement et nettoyage des documents scannés pour faciliter la lecture automatique
Corpus PDF hétérogènes – Uniformisation des résolutions, encodages et formats pour un traitement OCR

Traitement des documents bruts
Prendre en charge des fichiers sources non structurés ou difficiles à exploiter (scans, captures PDF, images, documents composites), afin de les convertir en contenus lisibles, segmentés et exploitables par des systèmes de traitement automatique, d’analyse ou d’IA.
Identification du type de document brut (scan image-only, PDF sans calque texte, capture mobile, etc.)
Segmentation du contenu en zones exploitables (paragraphes, tableaux, en-têtes, champs…)
Structuration du contenu selon les besoins métier (extraction, annotation, indexation)
Vérification manuelle sur un ensemble de documents critiques
Dossiers métiers mixtes – Traitement de documents composites (formulaires, notes, images) pour usage IA
Archives papier numérisées – Conversion de dossiers scannés en fichiers OCRisés lisibles par l’IA
Captures PDF sans texte – Extraction des zones utiles via segmentation visuelle puis OCR
Traitement linguistique
Nous transcrivons, traduisons et relisons vos contenus multilingues pour fournir à vos modèles des données linguistiques fiables.

Traitement multilingue
Gérer des documents écrits ou audio dans différentes langues — y compris des langues peu communes ou à fort contexte culturel — afin de les préparer à l’extraction, à l’annotation ou à la traduction. Cette étape permet d’assurer une prise en charge homogène, juste et robuste dans les projets d’IA multilingues.
Détecter automatiquement ou manuellement la langue du document
Faire intervenir un locuteur natif ou un annotateur spécialisé
Transcrire ou traduire les segments multilingues en conservant la structure originale
Encoder les données avec des métadonnées linguistiques (langue, registre, niveau)
Corpus NLP multilingue – Préparer des datasets équilibrés pour entraîner ou tester des modèles en langues multiples
Contrats internationaux – Structurer des documents juridiques multilingues pour extraction ou révision
Formulaires clients multirégionaux – Traiter des données clients dans plusieurs langues pour l’analyse ou la réponse automatique

Transcription et traduction humaine
Faire appel à des intervenants qualifiés pour transcrire fidèlement des fichiers audio ou vidéo, ou pour traduire des documents multilingues. Contrairement aux approches entièrement automatisées, cette méthode permet de gérer les nuances, corriger les erreurs, et produire des données fiables pour les modèles d’IA ou les usages critiques.
Découper les documents ou fichiers audio en segments exploitables
Transcrire manuellement les paroles ou textes, en respectant la ponctuation et les spécificités du langage parlé
Traduire le contenu dans la langue cible, avec une attention portée au ton, au registre et au contexte
Structurer les résultats (fichier bilingue, timestamps, métadonnées) et les exporter dans le format souhaité
Datasets audio pour NLP – Produire des corpus audio/texte validés pour la reconnaissance vocale ou la traduction automatique
Interviews ou podcasts – Transcrire et traduire des enregistrements pour créer des jeux de données IA multilingues
Appels clients – Transcrire et traduire les conversations du service client pour entraîner des assistants multilingues

Annotation multilingue
Annoter des documents ou des transcriptions dans différentes langues en y ajoutant des informations sémantiques, syntaxiques ou fonctionnelles. Cette étape est nécessaire pour entraîner ou tester des modèles de traitement du langage naturel (NLP) capables de comprendre et traiter une grande diversité linguistique.
Sélectionner les langues cibles et les types d’annotation à appliquer (entités nommées, émotions, intentions…)
Préparer les documents ou segments à annoter, en tenant compte des spécificités de chaque langue
Appliquer les annotations dans des interfaces adaptées (texte brut, fichiers audio, transcriptions)
Exporter les données annotées dans un format compatible avec les modèles multilingues (JSON, CSV, XML…)
Corpus NLP multilingue – Annoter les entités ou intentions dans plusieurs langues pour entraîner des LLM multilingues
Traductions annotées – Fournir des paires source-cible enrichies d’étiquettes sémantiques pour la traduction neuronale
Assistants vocaux internationaux – Annoter des dialogues audio ou texte dans plusieurs langues pour la compréhension d’intention

Relecture et validation humaine
Faire intervenir des experts linguistiques ou annotateurs spécialisés pour vérifier, corriger et valider des contenus issus de transcriptions, traductions ou traitements automatiques. Cette étape permet d’éliminer les erreurs, d’unifier les styles et de garantir la conformité aux exigences du projet ou du domaine (juridique, médical, administratif…).
Relire ligne par ligne ou bloc par bloc le contenu transcrit par l'IA, traduit ou annoté
Corriger les fautes, approximations ou incohérences (grammaire, style, terminologie, ponctuation…)
Valider ou invalider chaque élément selon des critères définis
Documenter les types d’erreurs rencontrés pour améliorer les étapes amont
Corpus de transcription – Corriger les erreurs de ponctuation, d’orthographe ou de découpage dans les textes générés automatiquement
Jeux d’entraînement pour IA – Valider manuellement les réponses IA ou transcriptions pour constituer un corpus de référence
Traductions techniques – Vérifier la cohérence terminologique dans des documents spécialisés

Validation des données extraites via OCR
Faire relire et corriger manuellement les textes générés par reconnaissance optique de caractères (OCR) à partir de documents scannés ou photographiés. Cette étape est indispensable pour garantir la fiabilité, la complétude et l’exploitabilité des données avant leur utilisation par des systèmes IA ou dans des flux métiers.
Collecter les résultats bruts de l’OCR (texte, structure, coordonnées spatiales)
Relire ligne par ligne ou bloc par bloc les extraits OCRisés
Corriger les erreurs typographiques, mots tronqués, caractères mal reconnus
Exporter les données corrigées dans un format structuré (texte enrichi, JSON, XML…) compatible avec les usages ultérieurs
Archives papier numérisées – Vérifier la lisibilité et la justesse des extraits OCR pour la constitution de corpus historiques
Dossiers réglementaires – Valider la conformité des extraits OCR pour audit ou soumission administrative
Factures ou relevés bancaires – Corriger les erreurs de reconnaissance dans les montants, numéros ou noms

Evaluation des transcriptions et traductions IA
Comparer les contenus générés automatiquement (par modèles de transcription ou de traduction) à des références humaines, afin de mesurer leur précision, fluidité, fidélité au sens original et adéquation contextuelle. Cette étape permet de calibrer les modèles, détecter les faiblesses et constituer des jeux de test fiables.
Collecter les résultats IA (transcriptions ou traductions)
Définir les critères d’évaluation (fidélité, grammaire, style, cohérence, erreurs critiques…)
Réaliser une évaluation humaine comparative (notation, classement ou commentaires qualitatifs)
Documenter les écarts significatifs et leurs causes (mauvaise segmentation, contre-sens, hallucination…)
Modèles de transcription vocale – Noter la justesse des transcriptions en contexte (bruit, accents, interruptions…)
Systèmes IA spécialisés – Vérifier que les traductions respectent les contraintes terminologiques métier (santé, juridique, technique)
Corpus de test multilingue – Évaluer la qualité des traductions dans plusieurs langues pour prioriser les améliorations
Classification de documents
Nous trions, étiquetons et enrichissons vos documents de métadonnées pour constituer des corpus propres et bien classés.

Tri manuel de documents
Faire intervenir des annotateurs pour classer des documents bruts dans des catégories définies (ex. : contrat, facture, rapport, pièce d’identité…), selon leur contenu, leur structure ou leur usage. Cette étape permet de préparer des corpus cohérents pour l’entraînement ou la validation de modèles de classification automatique, ou pour une exploitation directe par des équipes métiers.
Charger les documents dans une interface d’annotation adaptée (PDF, images, scans…)
Attribuer manuellement une ou plusieurs étiquettes par document
Contrôler la cohérence entre annotateurs (règles métier, cas ambigus…)
Exporter les résultats (fichier + catégorie associée) dans un format structuré (CSV, JSON)
Archivage automatisé – Créer un jeu de données classifié pour entraîner un modèle de tri automatique
Traitement réglementaire – Identifier les documents réglementés à isoler ou traiter en priorité
Corpus documentaire brut – Classer les fichiers selon leur type (facture, contrat, bulletin de paie…)

Vérification des classifications IA
Relire manuellement les prédictions faites par un modèle de classification de documents pour valider ou corriger les catégories attribuées. Cela permet de garantir une haute précision dans les systèmes de tri automatisé, de constituer des jeux de données de validation fiables, ou de générer des retours utiles pour l’amélioration du modèle.
Relire le contenu de chaque document pour en vérifier la classification automatique
Accepter ou corriger l’étiquette proposée par le modèle
Marquer les documents problématiques (manque d’info, bruit, contenu mixte…)
Exporter les résultats vérifiés pour analyse de performance ou re-entraînement
Amélioration continue – Corriger les prédictions erronées pour réentraîner un modèle plus performant
Audit de modèle de classification – Vérifier la précision réelle d’un classifieur IA sur un corpus métier
Fiabilisation d’un pipeline automatisé – Intégrer une étape humaine dans un processus de tri critique

Labellisation de documents
Attribuer une ou plusieurs étiquettes à des fichiers selon leur nature, leur contenu ou leur objectif métier. Cette étape est essentielle pour créer des datasets d’entraînement supervisés pour des modèles de classification ou de tri automatique, ou pour générer une vérité terrain ("ground truth") utilisée en phase de test ou d’évaluation.
Définir un ensemble clair et cohérent de classes ou d’étiquettes
Charger les documents à annoter dans un outil adapté (Label Studio, Doccano, outil interne…)
Annoter avec précision, selon les consignes définies
Exporter les documents annotés avec leurs étiquettes dans un format structuré
Benchmarking – Créer une vérité terrain pour tester la performance d’un modèle sur des cas réels
Organisation documentaire – Structurer un volume important de documents pour faciliter leur exploitation métier
Entraînement de classifieurs IA – Produire un corpus annoté pour apprendre à reconnaître les types de documents

Segmentation de documents
Identifier et séparer les différentes parties d’un document composite (ex. : rapport, contrat, dossier administratif), afin de classer chaque segment indépendamment, ou d’en extraire les zones pertinentes pour annotation, extraction ou traitement IA.
Segmenter le fichier manuellement ou semi-automatiquement (page par page ou bloc par bloc)
Annoter chaque segment avec une étiquette ou un type associé
Vérifier la cohérence des segments découpés (ordre, complétude, typage)
Exporter les segments dans des fichiers séparés ou dans un format structuré avec leurs métadonnées
Rapports réglementaires – Découper automatiquement les sections (résumé, analyse, annexes) pour traitement ciblé
Contrats complexes – Extraire et classer les clauses, conditions et annexes pour annotation ou extraction
Dossiers clients ou RH – Identifier les pièces individuelles à l’intérieur d’un PDF global

Ajout de métadonnées
Associer à chaque document ou segment des informations descriptives, techniques ou contextuelles (type, date, langue, origine, niveau de sensibilité…). Ces métadonnées permettent d’améliorer la recherche, la classification, la gestion documentaire ou encore l’entraînement de modèles IA plus fiables.
Définir les types de métadonnées utiles selon les objectifs du projet (ex. : typologie, source, confidentialité…)
Saisir ou sélectionner les métadonnées via un outil d’annotation ou une grille manuelle
Lier les métadonnées aux documents dans le format cible (via des champs intégrés, ou en base externe)
Exporter les fichiers enrichis (JSON, CSV, base de données ou index documentaire)
Préparation de datasets IA – Fournir des indications supplémentaires aux modèles pour affiner les prédictions
Bases documentaires métiers – Enrichir les fichiers avec des catégories métier, dates clés ou tags thématiques
Outils de recherche intelligente – Améliorer le filtrage et la navigation dans les archives grâce à des métadonnées enrichies

Nettoyage qualitatif
Relire et filtrer manuellement un ensemble de documents afin de supprimer les fichiers bruités, incomplets, hors sujet, en double ou non exploitables. Cette étape permet de garantir que seuls les documents pertinents, lisibles et utiles sont conservés dans un corpus destiné à l’entraînement d’un modèle ou à une classification fiable.
Définir les critères d’exclusion (qualité d’image, contenu vide, mauvaise langue, doublons, non pertinents…)
Parcourir les documents dans un outil de revue rapide ou d’annotation
Marquer les fichiers non conformes selon leur motif d’exclusion
Documenter les motifs et volumes de rejet pour traçabilité ou amélioration du sourcing
Nettoyage de corpus collecté sur le web ou en entreprise – Éliminer les documents parasites ou inutiles
Préparation à l’annotation – Garantir un corpus propre et cohérent avant le lancement d’une phase de labellisation
Constitution d’un jeu d’entraînement IA – Retirer les documents flous, hors domaine ou mal scannés
Supervision et validation humaine
Nos annotateurs vérifient et corrigent les résultats de vos outils OCR et d'extraction pour fiabiliser vos données avant l'entraînement.

Vérification manuelle des données extraites
Faire intervenir des réviseurs humains pour valider ou corriger les données récupérées automatiquement à partir de documents (ex. : montants, dates, noms, champs techniques). Cette étape permet de fiabiliser les données structurées, en particulier dans les contextes sensibles ou réglementés.
Importer les documents sources et leurs données extraites (par OCR ou parsing)
Corriger les erreurs détectées (mots tronqués, montants erronés, entités mal reconnues, …)
Marquer les cas ambigus ou non exploitables
Exporter les données relues dans un format structuré (CSV, Excel, base de données)
Fiches produit ou catalogues – Contrôler les champs techniques issus du parsing automatique
Corpus de test pour IA – Produire des données 100 % vérifiées pour entraîner ou évaluer un modèle
Factures ou contrats – Vérifier que les montants, dates et parties prenantes extraits sont exacts

Ajustement manuel OCR ou parsing
Intervenir directement sur les résultats d’une extraction automatisée (texte OCR, parsing HTML ou XML, extraction PDF) afin de rectifier les erreurs localisées, comme des mots mal reconnus, des lignes mal segmentées ou des champs mal associés. Cette intervention ciblée améliore significativement la qualité globale des données extraites.
Identifier les documents ou segments présentant des erreurs de reconnaissance
Corriger manuellement les erreurs détectées (textes tronqués, champs inversés, paragraphes fusionnés…)
Réaligner les segments mal positionnés ou mal typés
Exporter les données ajustées dans un format compatible avec le reste du corpus
Parsing de PDF complexes – Réassocier les bonnes étiquettes à des tableaux ou paragraphes mal extraits
Formulaires scannés – Réaligner les champs OCRisés avec les libellés d’origine
OCR sur documents techniques – Corriger des lignes mal segmentées ou des symboles mal reconnus

Relecture de documents
Relire intégralement ou partiellement des documents extraits, transcrits ou traités automatiquement afin de corriger les erreurs, valider la mise en page, ou détecter les anomalies. Cette étape permet de garantir une qualité linguistique, technique ou réglementaire avant diffusion, archivage ou annotation.
Charger les documents originaux et leur version traitée (OCR, parsing, transcription, …)
Corriger les erreurs de contenu, de style ou de structure (erreurs, segments mal ordonnés, répétitions)
Valider ou rejeter les documents selon les critères qualité définis
Documenter les erreurs fréquentes pour ajuster les étapes amont
Corpus IA – Relire des documents annotés ou extraits avant entraînement de modèle
Archivage structuré – Vérifier que les documents extraits sont lisibles, complets et exploitables
Documents réglementaires – Relire et corriger des transcriptions pour audit ou soumission officielle

Tagging de données sensibles
Détecter, annoter ou masquer les éléments d’un document contenant des informations personnelles, confidentielles ou réglementées (PII, données de santé, mentions légales, etc.).
Définir les types de données sensibles à repérer (nom, numéro, adresse, ID, données médicales…)
Charger les documents textuels, transcrits ou OCRisés dans un outil d’annotation
Appliquer des balises, des masques ou des anonymisations selon les règles du projet
Exporter le document annoté, pseudonymisé ou prêt à l’entraînement IA
Préparation de datasets pour LLM – Supprimer ou baliser les informations à caractère personnel avant entraînement
Traitement de dossiers RH ou médicaux – Identifier les mentions sensibles pour pseudonymisation ou audit
Conformité réglementaire – Garantir le respect du RGPD ou des standards sectoriels (ex. : HIPAA, AI Act)

Jeux de test pour OCR / NLP
Sélectionner, corriger et valider manuellement des documents ou extraits représentatifs, afin d'en faire des jeux de test pour mesurer la précision, la robustesse et les erreurs des modèles de reconnaissance ou de compréhension de documents.
Sélectionner un échantillon diversifié et représentatif des documents ou cas d’usage
Appliquer une annotation manuelle de très haute qualité
Comparer les résultats IA à cette référence pour calculer des scores (précision, F1, CER, etc.)
Documenter les types d’erreurs observés pour orienter les corrections ou le fine-tuning
Tests de modèles NLP multilingues – Mesurer la performance par langue ou par type de document
Suivi qualité dans des pipelines IA – Contrôler régulièrement les dérives ou régressions d’un système en production
Évaluation de moteurs OCR – Comparer le texte extrait automatiquement à une version 100 % relue

Correction découpage automatique
Vérifier et ajuster manuellement les découpes réalisées par un système de segmentation automatique (ex. : OCR, parsing PDF, détection de blocs ou de pages).
Charger les documents et leur découpage initial dans une interface de revue ou d'annotation
Fusionner, scinder ou réordonner les segments selon la structure logique attendue
Valider la cohérence du document reconstruit
Exporter le fichier corrigé avec sa structure mise à jour (JSON, XML, etc.)
Tableaux extraits – Corriger la séparation des colonnes ou lignes dans des documents financiers
Formulaires scannés – Réajuster les blocs mal alignés pour permettre une annotation ou extraction fiable
Contrats ou rapports PDF – Réorganiser les sections mal interprétées par un outil d’OCR ou parsing
Cas d’usage
De la facture au dossier médical en passant par le contrat, voici trois projets types :

Pourquoi choisir
Innovatiana ?
Nous mettons à votre service une équipe d’experts rigoureux et adaptables, spécialisée dans la structuration, la révision et l’enrichissement de corpus documentaires, pour alimenter et optimiser vos modèles IA
Conçu pour la production
Une approche structurée de bout en bout pour transformer vos données brutes en datasets fiables, validés et prêts pour la production.
Nos équipes de Data Labelers et AI Trainers sont sélectionnées, formées et pilotées par des experts afin de garantir un haut niveau de qualité, de cohérence et de performance à chaque étape du projet.
Nous analysons vos données, vos objectifs et vos contraintes afin de définir l’approche la plus pertinente : méthodologie, profils mobilisés, outils, critères qualité, volumes et cadence de production.
Avant toute montée en charge, nous calibrons le dispositif sur un échantillon représentatif. Les instructions sont affinées, les cas limites identifiés et les critères d’acceptation validés avec vos équipes.
Nous mobilisons une équipe spécifiquement sélectionnée et formée pour votre projet, pilotée par un Data Labeling Manager. Annotation, évaluation ou enrichissement : nous opérons dans nos outils ou directement dans votre environnement.
Ils témoignent
Dans un secteur où les pratiques opaques et les conditions précaires sont trop souvent la norme, Innovatiana fait figure d'exception. Cette entreprise a su bâtir une approche éthique et humaine du data labeling, en valorisant les annotateurs comme des experts à part entière du cycle de développement de l’IA. Chez Innovatiana, les data labelers ne sont pas de simples exécutants invisibles ! Innovatiana propose une approche responsable et durable.


Innovatiana nous accompagne dans la révision et l’amélioration des jeux de données utilisés pour entraîner nos modèles de machine learning. Grâce à leur soutien, nous avons revu plus de 50 000 annotations et réduit de 30 % le temps consacré à la vérification. L’équipe est engagée, fiable et toujours prête à trouver des solutions. J’apprécie particulièrement la proximité et les échanges directs avec des interlocuteurs qui comprennent nos besoins et les contraintes de nos projets. Je recommande Innovatiana sans hésiter !


Innovatiana a annoté pour nous plus de 20 000 annonces immobilières en français afin d’entraîner nos modèles de classification et de reconnaissance de texte. Ce travail minutieux a atteint un taux de conformité de 98 % à nos consignes d’annotation, avec 100 % des lots livrés dans les délais convenus. Nous apprécions la qualité des livrables et la stabilité de l’équipe, qui connaît bien nos exigences. Les échéances sont clairement définies et les échanges sont fluides tout au long du projet. Nous leur confierons sans hésiter de nouvelles missions en NLP ou en computer vision.


Plusieurs annotateurs d’Innovatiana sont intégrés à plein temps à notre équipe de chirurgiens et de data scientists. Ensemble, nous avons annoté plus de 67 000 images issues de plus de 60 interventions chirurgicales, couvrant une trentaine de catégories d’instruments. J’apprécie la rigueur technique de l’équipe et l’implication des étudiants en médecine mobilisés sur nos projets. Leur compréhension du contexte médical et leur attention aux détails nous permettent de constituer des jeux de données de qualité pour entraîner nos modèles d’IA.


Innovatiana fait partie de la quatrième promotion de notre accélérateur à impact. Avec son studio d’annotation de données à Majunga, Madagascar, l’entreprise donne tout son sens à l’externalisation responsable : créer des emplois locaux dans des territoires où les opportunités sont limitées, valoriser l’expertise des annotateurs et placer la transparence et la qualité des conditions de travail au cœur de son modèle. Une illustration concrète de la manière dont la filière IA peut générer un impact social positif.


Chez Innovatiana, l’engagement pour une IA éthique commence par le respect des personnes qui la rendent possible. Des conditions de travail équitables, un environnement bienveillant et une réelle reconnaissance de l’expertise des annotateurs sont au cœur de son modèle. Cette attention portée aux équipes se traduit par un travail rigoureux et des données de qualité. Une approche qui montre que responsabilité sociale et exigence technique vont de pair.


Innovatiana montre qu’une IA performante se construit aussi sur des engagements humains forts. L’entreprise fait de l’éthique un principe concret, intégré dès la préparation des données, en reconnaissant le rôle essentiel et l’expertise des annotateurs. Une démarche qui place le respect des personnes au cœur du progrès technologique.


Innovatiana nous a accompagnés dans l’annotation de plus de 30 000 images d’inspection de canalisations, couvrant plus de 50 classes selon une grille fondée sur la norme EN 13508-2. Ce projet exigeait une analyse minutieuse des images et une distinction précise entre des catégories parfois très proches. L’équipe a fait preuve de réactivité, de rigueur et d’une réelle implication pour comprendre nos exigences métier. Nous avons particulièrement apprécié la cohérence des annotations et la qualité des livrables, malgré la complexité du projet.


Innovatiana montre la voie dans le secteur de l’annotation de données en associant expertise technique, exigence de qualité et engagement éthique. L’entreprise investit dans ses annotateurs à travers la formation, un encadrement solide et des conditions de travail équitables et transparentes. Un modèle qui accorde autant d’importance à la qualité des données qu’aux personnes qui les rendent possibles.


🤝 L’éthique au cœur de nos valeurs
De nombreuses sociétés de Data Labeling peuvent recourir à des pratiques discutables dans des pays à faible revenu. Nous proposons une alternative éthique et impactante.
Des emplois stables et équitables, avec une transparence totale sur l'origine des données
Une équipe de Data Labelers formée, équitablement rémunérée et accompagnée dans son évolution
Une tarification flexible à la tâche ou au projet, sans frais cachés ni engagement
Un développement vertueux à Madagascar (et ailleurs) via la formation et l'investissement local
Une protection maximale de vos données sensibles selon les meilleurs standards (RGPD, ISO 27001) et conforme aux réglementations (EU AI Act)
L'accélération d'une IA éthique globale grâce à des équipes dédiées
Transformez vos documents en données prêtes pour l'IA !

