Muffin vs Chihuahua: conjunto de datos de clasificación binaria
Un conjunto de datos de imágenes humorísticas y educativas que contiene casi 6.000 imágenes de magdalenas y chihuahuas, diseñado para la clasificación binaria.
Descripción
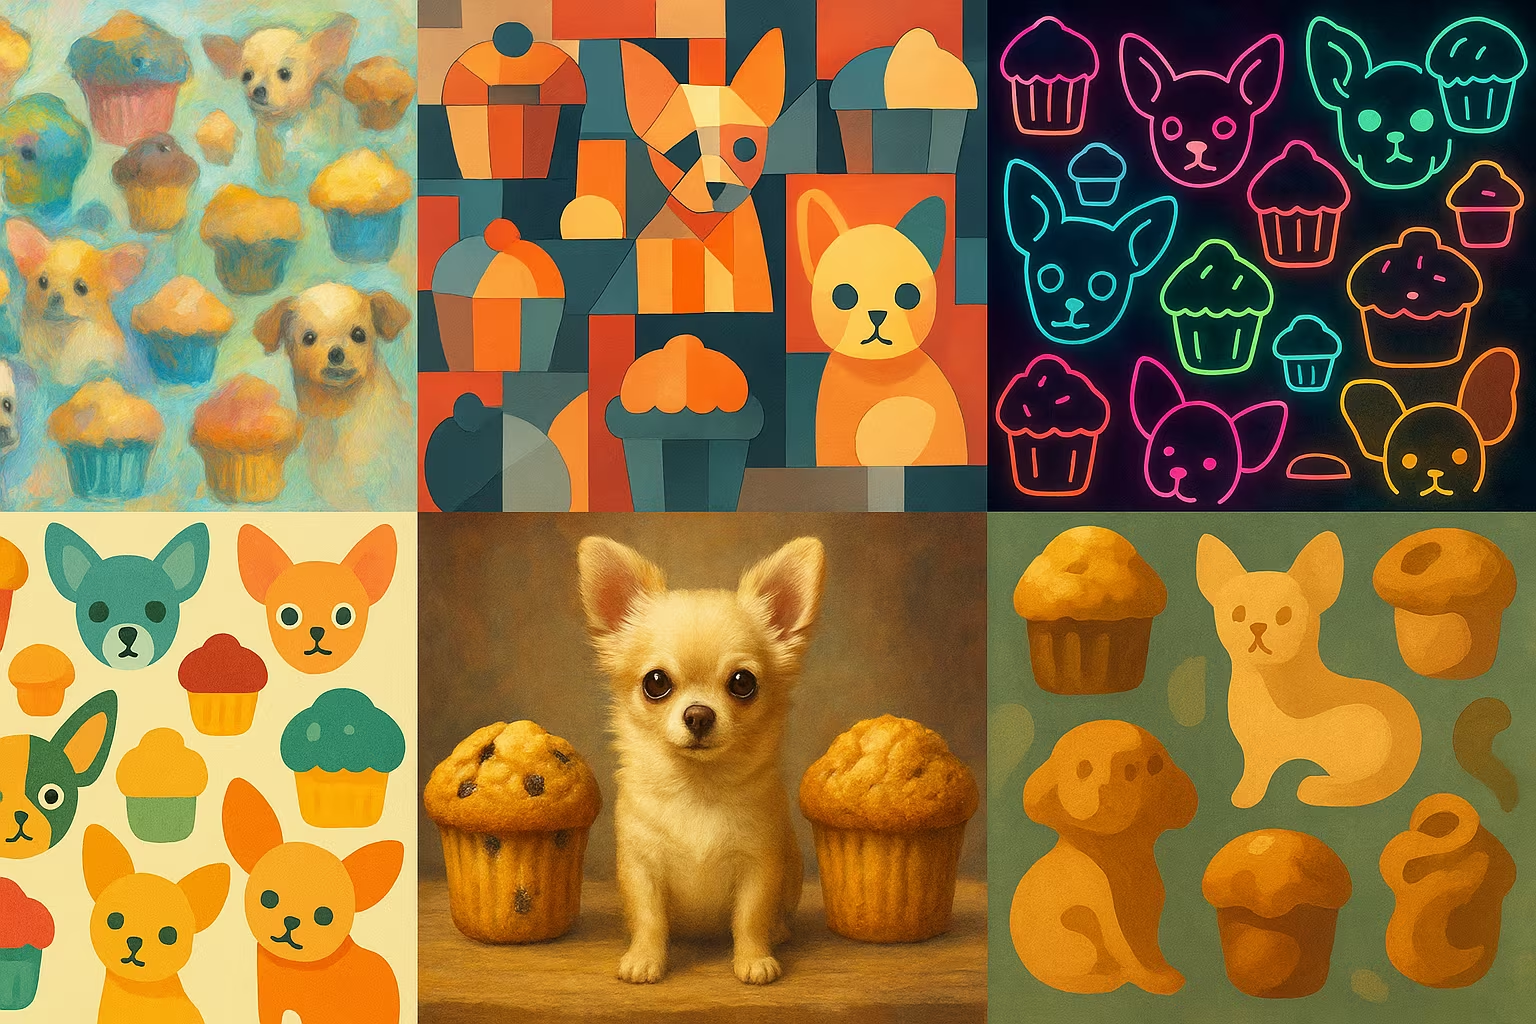
El conjunto de datos Muffin contra Chihuahua es un conjunto de datos visuales basado en el famoso meme de Internet en el que las magdalenas parecen chihuahuas. Incluye cerca de 6.000 imágenes divididas en dos clases: magdalenas y chihuahuas. Este es un ejemplo perfecto de un problema de clasificación de imágenes divertido pero relevante en la visión artificial.
¿Para qué sirve este conjunto de datos?
- Entrenamiento de un modelo de CNN para resolver un problema de clasificación binaria
- Probar la solidez de las redes convolucionales frente a imágenes visualmente similares
- Cree demostraciones divertidas de modelos de IA para el público en general
¿Se puede enriquecer o mejorar?
El conjunto de datos se puede enriquecer añadiendo otros pares de objetos visualmente similares (por ejemplo, serpientes contra espaguetis, perros contra animales de peluche) para crear una serie de divertidos conjuntos de datos de clasificación binaria. También se pueden aplicar mejoras a la imagen (recorte, desenfoque, brillo) para mejorar la solidez de los modelos.
🔎 En resumen
🧠 Recomendado para
- Proyectos educativos
- Demostraciones de IA accesibles
- Ejercicios de clasificación de CNN
🔧 Herramientas compatibles
- Keras
- PyTorch
- FastAI
- OpenCV
💡 Consejo
Para demostrar la dificultad, aplica un poco de desenfoque o un recorte ajustado durante el entrenamiento.
Preguntas frecuentes
¿Este conjunto de datos es adecuado para una demostración de IA para el público en general?
Sí, es perfecto para ilustrar lo difícil que es para las IA distinguir imágenes que tienen un aspecto muy similar.
¿Podemos agregar otros pares de objetos similares para enriquecer este conjunto de datos?
Sí, incluso se recomienda para crear un conjunto de conjuntos de datos técnicos y humorísticos.
¿Se puede usar para un proyecto comercial o en producción?
Sí, la licencia CC0 permite la reutilización gratuita, incluso en contextos comerciales.