Muffin vs Chihuahua – Dataset de Classification Binaire
Dataset d’images humoristique et éducatif contenant près de 6 000 images de muffins et de chihuahuas, conçu pour la classification binaire.
Description
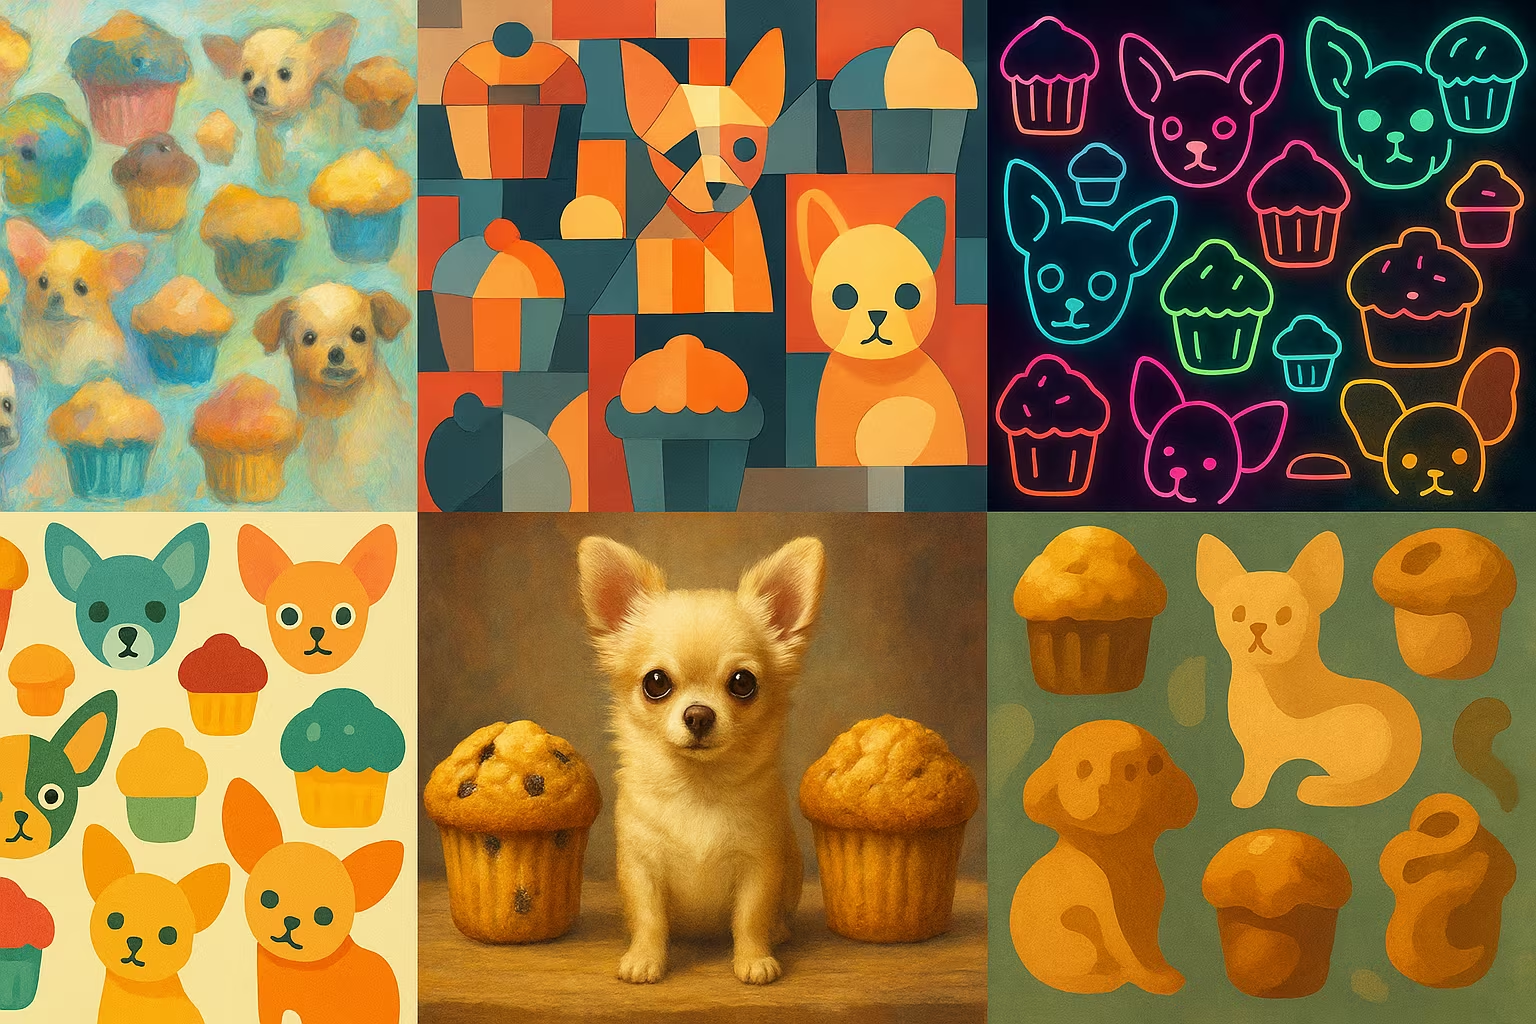
Le dataset Muffin vs Chihuahua est un jeu de données visuel basé sur le célèbre mème Internet où des muffins ressemblent à des chihuahuas. Il comprend près de 6 000 images réparties en deux classes : muffins et chihuahuas. C’est un exemple parfait de problème de classification d’images humoristique mais pertinent en vision par ordinateur.
À quoi sert ce dataset ?
- Entraîner un modèle CNN à résoudre un problème de classification binaire
- Tester la robustesse des réseaux convolutifs face à des images visuellement similaires
- Créer des démonstrations ludiques de modèles d’IA pour le grand public
Peut-on l’enrichir ou l’améliorer ?
Le dataset peut être enrichi en ajoutant d’autres paires d’objets visuellement similaires (ex. serpents vs spaghetti, chiens vs peluches) pour créer une suite de jeux de données de classification binaire amusants. On peut également appliquer des augmentations d’image (recadrage, flou, luminosité) pour améliorer la robustesse des modèles.
🔎 En résumé
🧠 Recommandé pour
- Projets éducatifs
- Démos d’IA accessibles
- Exercices de classification CNN
🔧 Outils compatibles
- Keras
- PyTorch
- FastAI
- OpenCV
💡 Astuce
Pour démontrer la difficulté, appliquez un flou léger ou des recadrages serrés pendant l’entraînement.
Questions fréquemment posées
Ce dataset est-il adapté à une démonstration d’IA pour le grand public ?
Oui, il est parfait pour illustrer la difficulté des IA à distinguer des images très similaires d’apparence.
Peut-on ajouter d'autres paires d’objets similaires pour enrichir ce dataset ?
Oui, c’est même recommandé pour créer une suite de jeux de données humoristiques et techniques.
Est-il utilisable pour un projet commercial ou en production ?
Oui, la licence CC0 permet une réutilisation libre, y compris dans des contextes commerciaux.